汇总30000份中国各区县政府工作报告-文本大数据
- 2026-10-18 20:35:35
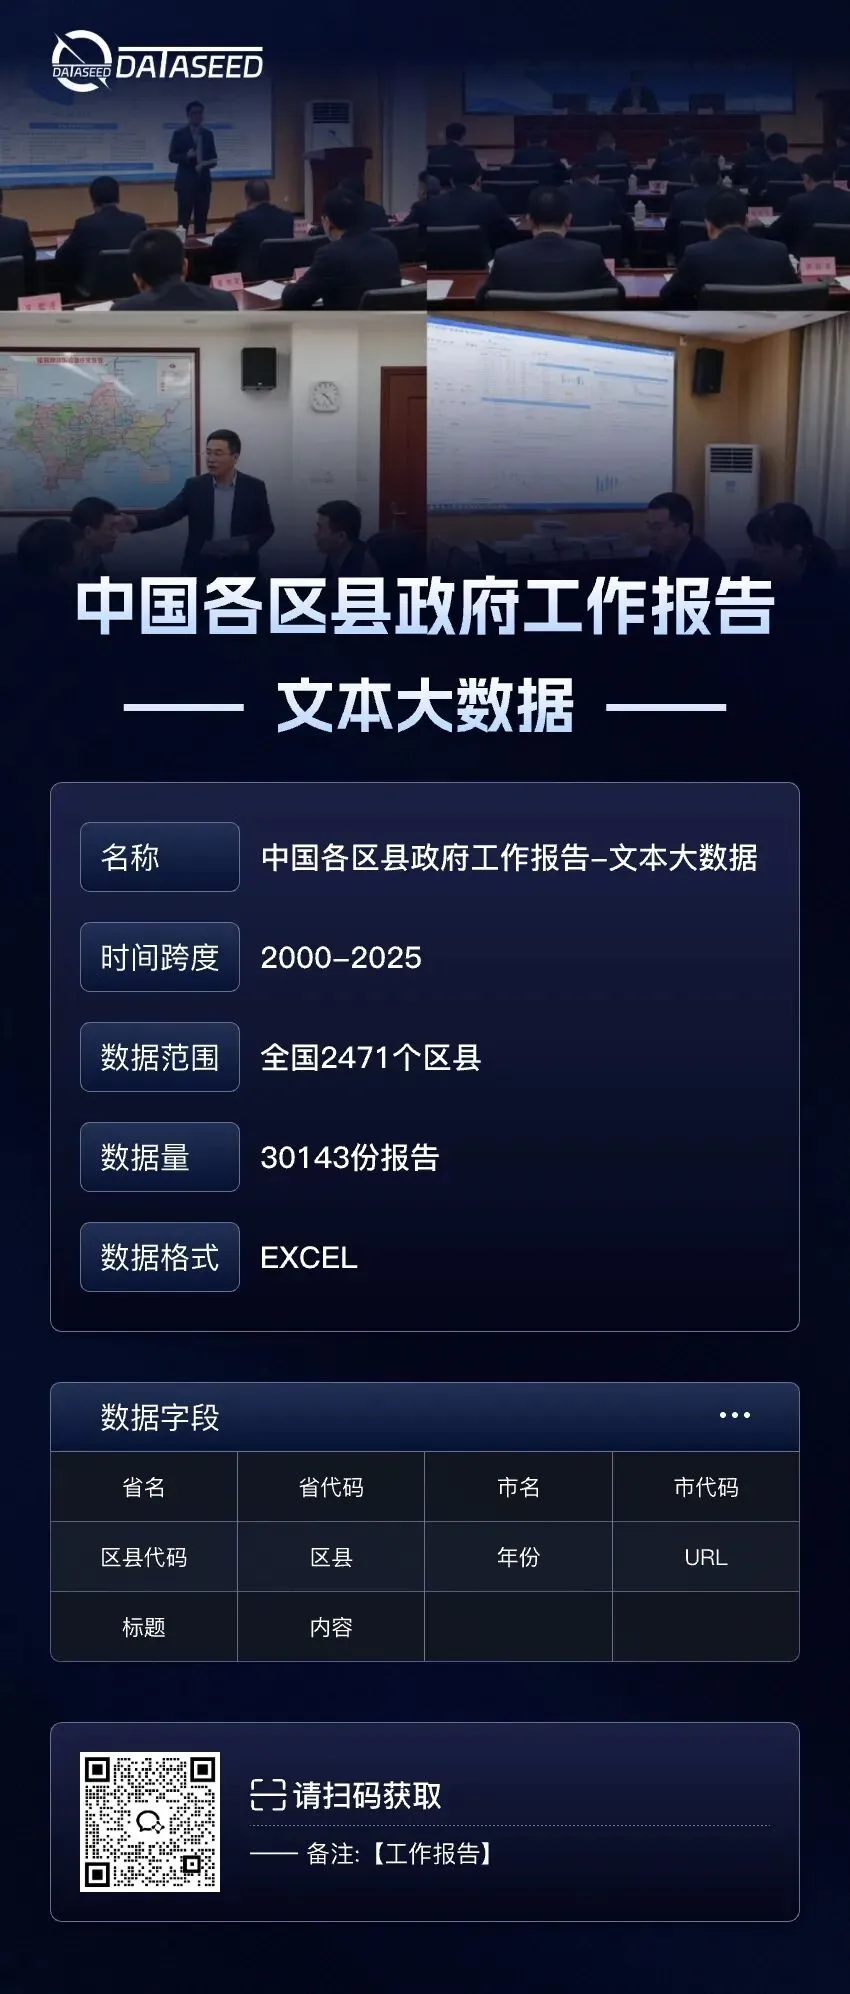
一、数据简介
从文字到治理,透视中国地方政策的真实语境!
在中国的治理体系中,区县层级是政策执行与社会运行的关键一环。政府工作报告作为地方治理的“年度总结与展望”,记录了政府的施政逻辑、政策取向与发展愿景,是理解基层治理行为与政策演进的核心文本。然而,长期以来,学界与业界获取的多为省市级文献,系统化、结构化的县级报告原文数据仍极为稀缺。
为填补这一空白,Dataseed团队推出《中国区县政府工作报告原文数据库》,通过标准化清洗与格式统一,系统汇聚了全国县级行政区历年政府工作报告原文,涵盖PDF与TXT等多源文本,并汇总为可检索、可分析的Excel结构化语料。这一数据库完整保留原始语言、政策表述与上下文逻辑,为文本挖掘、语义分析、政策演化研究提供了坚实的数据底座。
研究者可借助该数据库,量化追踪地方政策关注主题的变迁,识别县域发展叙事的空间差异,挖掘政策语言的演化逻辑与治理话语结构。无论是经济学、公共管理、政治学、区域发展研究,还是自然语言处理与大模型训练,《中国区县政府工作报告原文数据库》都为理解中国基层治理的政策生成机制与叙事生态提供了前所未有的语料支撑,开启文本数据驱动的地方治理研究新时代。
二、数据概览
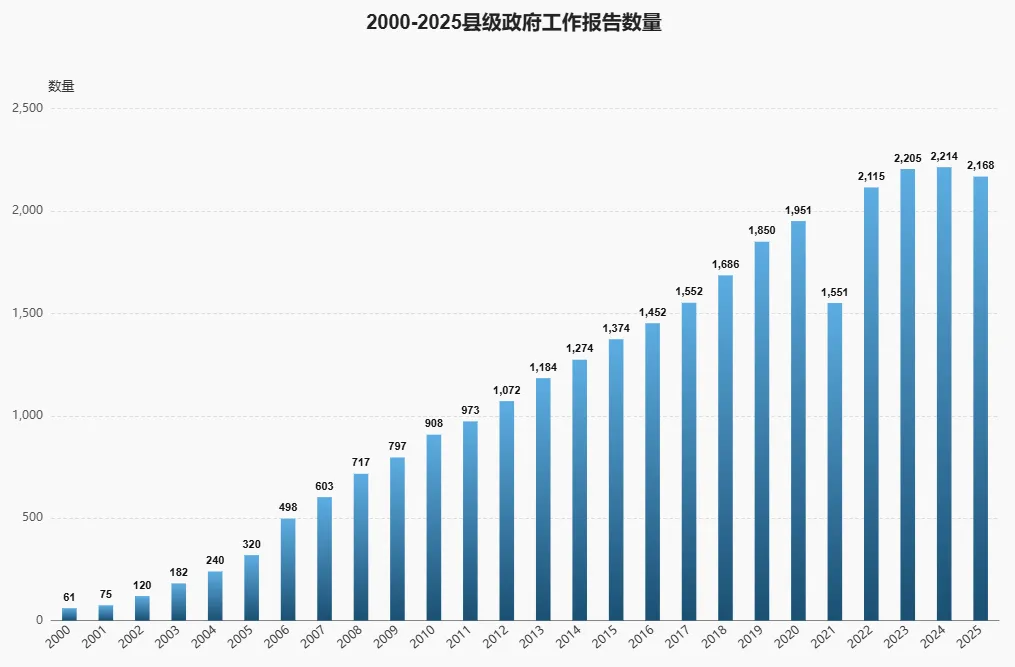
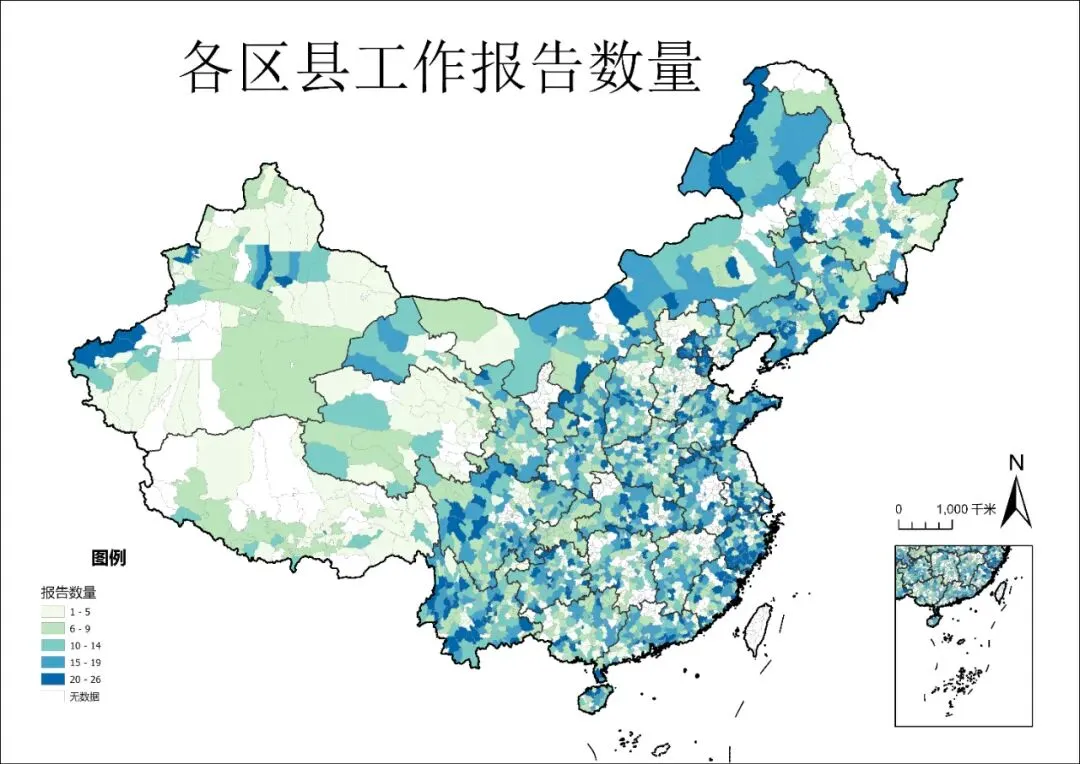
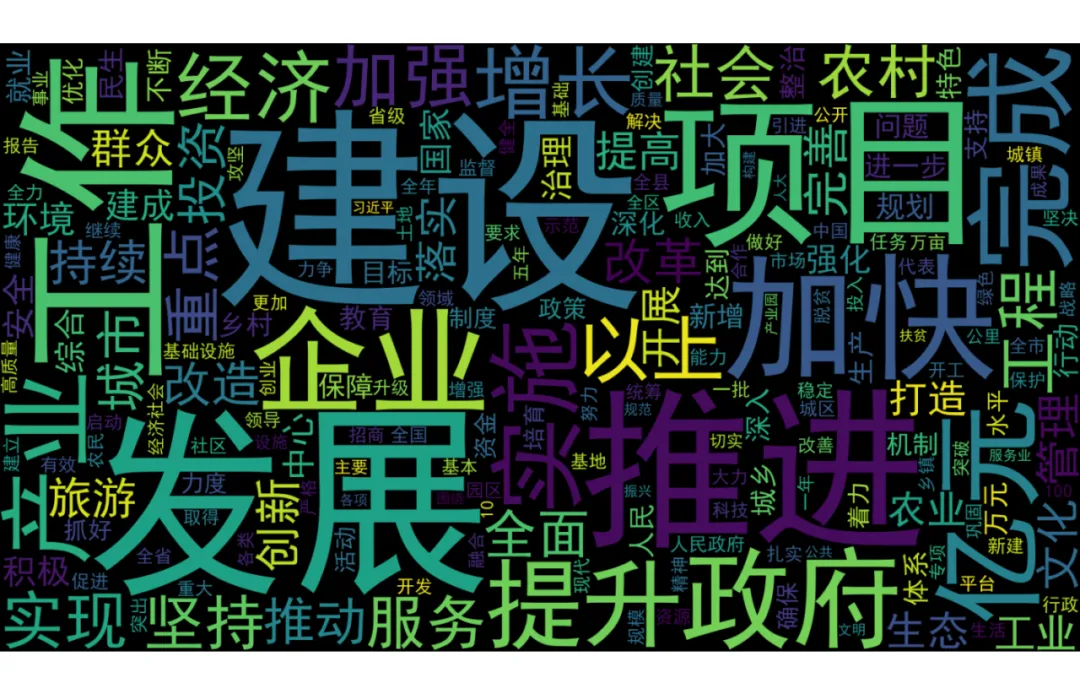
数据字段:
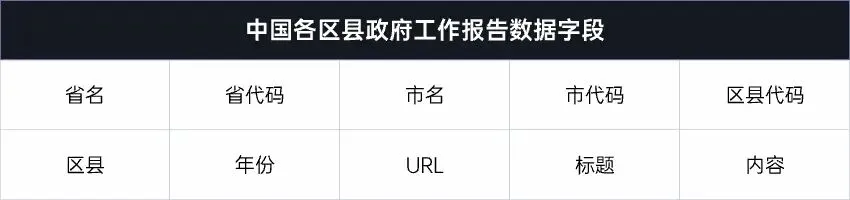
数据表格:
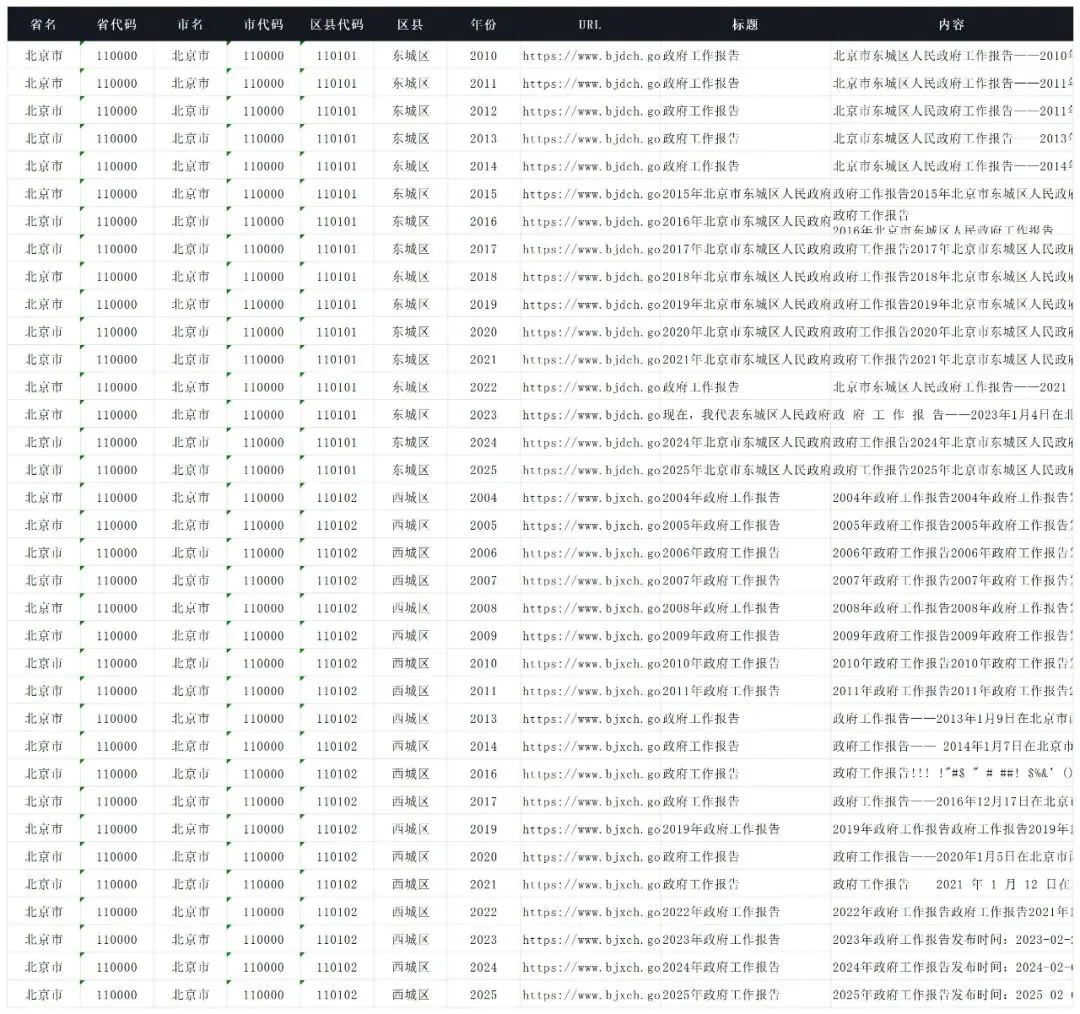
三、相关工作-县级政府工作报告原文整理
为构建高质量的县域政府工作报告数据库,我们在获取各个工作报告文件后,还需要对文件进行标准化编码与去噪处理,将清洗后的文本内容按“省—市—县—年份—报告正文”五级结构汇总至Excel文件。
数据获取
pattern = r'(?:href|src)=["\']((?:[^"\']*?\.(?:doc|docx|pdf|zip))(?:[^"\']*))["\']'matches = re.findall(pattern, content, re.IGNORECASE)full_urls = [urljoin(base_url, m) for m in matches]文本数据标准化
为确保正文纯净,程序自动识别“政府工作报告”开头,并剔除网页导航、版权标识和短句符号等非正文内容。
if re.search(r'\d{4}年.*?政府工作报告', line): report_start = i...if any(word in line for word in ['回到顶部', '党政机关标识']): report_end = i四、相关研究
部分相关研究示例
Chang, K., Li, J., Wei, S. et al. Impact of government’s dual-carbon attention on urban carbon emissions reduction: evidence from the Yangtze River Delta. Sci Rep 15, 37003 (2025). https://doi.org/10.1038/s41598-025-03541-3
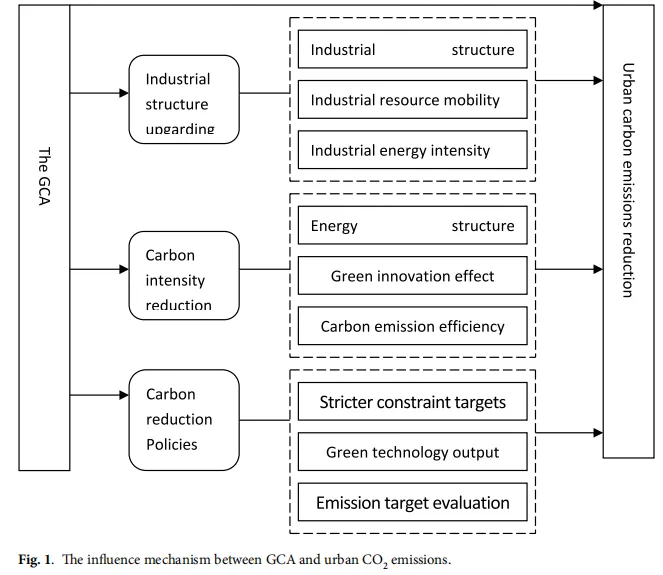
政府双碳关注度与二氧化碳排放的影响机制
更多相关研究:
[1]詹新宇,刘文彬.中国式财政分权与地方经济增长目标管理——来自省、市政府工作报告的经验证据[J].管理世界,2020,36(03):23-39+77.DOI:10.19744/j.cnki.11-1235/f.2020.0032.
[2]王印红,李萌竹.地方政府生态环境治理注意力研究——基于30个省市政府工作报告(2006—2015)文本分析[J].中国人口·资源与环境,2017,27(02):28-35.DOI:CNKI:SUN:ZGRZ.0.2017-02-006.
[3]王海军,伍骏骞,谢凯,等.政府就业增长目标、民生保障性财政支出偏好与稳就业效应[J].经济研究,2025,60(03):87-105.DOI:CNKI:SUN:JJYJ.0.2025-03-006.
[4]詹新宇,刘文彬.中国式财政分权与地方经济增长目标管理——来自省、市政府工作报告的经验证据[J].管理世界,2020,36(03):23-39+77.
六、获取方式
数据编号
D1715
DataSeed大数据库
扫码添加会员助理,备注【工作报告】
https://cndataseed.com/
点击左下角“阅读原文”,获取更多数据

