地级市政府工作报告文本分析数据:数字化政府建设指数
- 2026-10-14 15:12:31
地级市政府工作报告文本分析数据:数字化政府建设指数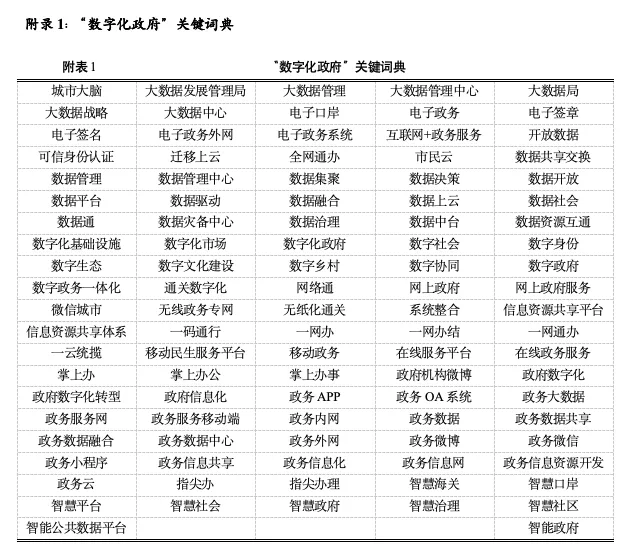
词典来源:刘文革等(2024) 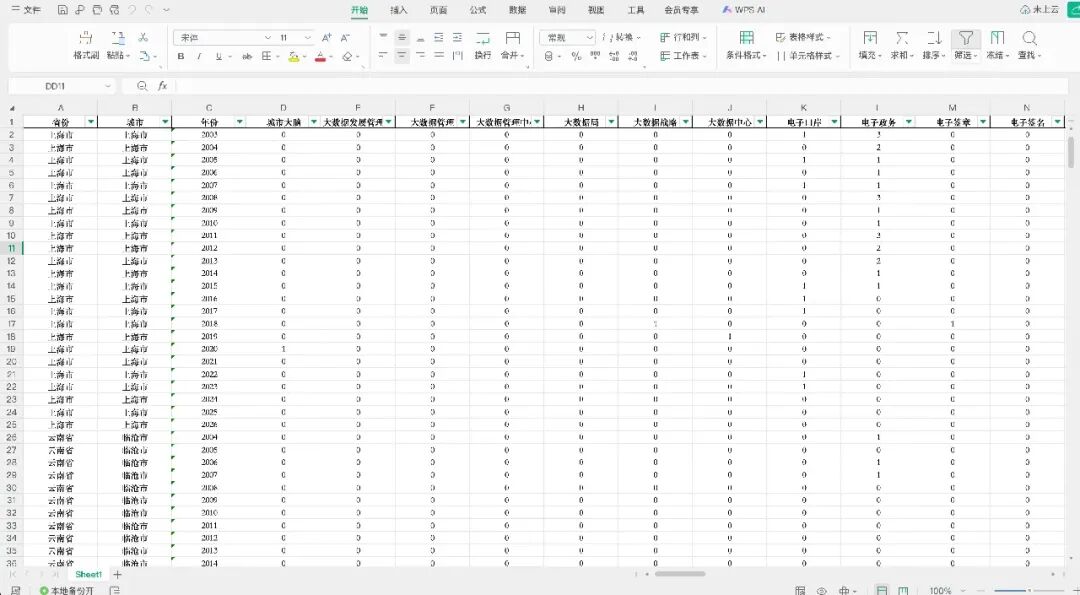
数字化政府建设是各级政府积极融入“数字革命”浪潮的重要途径,如何准确科学测度各级政府的数字化建设程度是一个前沿学术问题。
政府工作报告中关于某一特定领域词汇的表述频次,能够直观反映地方政府对特定领域的政策关注度和治理导向,因此从非结构化的政府工作报告文本大数据中提取有效信息,使用词频统计方法刻画数字化政府建设指数成为了现阶段一种可供操作的测算方法。
数据来源
从各城市政府官网、报刊、年鉴和方志等渠道收集整理了2003-2026年326个城市共计7531份政府工作报告文本。
具体可参见“精品数据:中国各省、地级市政府工作报告数据集(2003-2026)”一文。
分词统计
参考刘文革等(2024)的做法,使用“数字化政府”、“大数据管理” 等102个关键词汇,建立“数字化政府”关键词典。
使用 Python中jieba库,对地级市报告文本进行分词处理,并进行清洗,去除停用词后,分别统计各个数字化政府相关词汇出现的频次,而后计算数字化政府相关词汇出现的总频次占政府工作报告全文总词频数的比例,以此来刻画数字化政府建设指数。
import osimport jiebaimport pandas as pd# ================= 配置区域 =================# 1. 设置政府工作报告根目录路径 (请修改为实际路径)REPORT_ROOT = "/政府工作报告-市级"# 2. 设置停用词表路径 (请修改为实际路径)STOPWORDS_PATH = "hit_stopwords.txt"# 3. 设置输出Excel文件名OUTPUT_EXCEL = "地级市数字化政府词频统计结果.xlsx"# 4. 需要统计的53个环境词汇列表ENV_KEYWORDS = ["城市大脑","大数据发展管理局","大数据管理","大数据管理中心","大数据局","大数据战略","大数据中心","电子口岸","电子政务","电子签章","电子签名","电子政务外网","电子政务系统","互联网+政务服务","开放数据","可信身份认证","迁移上云","全网通办","市民云","数据共享交换","数据管理","数据管理中心","数据集聚","数据决策","数据开放","数据平台","数据驱动","数据融合","数据上云","数据社会","数据通","数据灾备中心","数据治理","数据中台","数据资源互通","数字化基础设施","数字化市场","数字化政府","数字社会","数字身份","数字生态","数字文化建设","数字乡村","数字协同","数字政府","数字政务一体化","通关数字化","网络通","网上政府","网上政府服务","微信城市","无线政务专网","无纸化通关","系统整合","信息资源共享平台","信息资源共享体系","一码通行","一网办","一网办结","一网通办","一云统揽","移动民生服务平台","移动政务","在线服务平台","在线政务服务","掌上办","掌上办公","掌上办事","政府机构微博","政府数字化","政府数字化转型","政府信息化","政务APP","政务OA系统","政务大数据","政务服务网","政务服务移动端","政务内网","政务数据","政务数据共享","政务数据融合","政务数据中心","政务外网","政务微博","政务微信","政务小程序","政务信息共享","政务信息化","政务信息网","政务信息资源开发","政务云","指尖办","指尖办理","智慧海关","智慧口岸","智慧平台","智慧社会","智慧政府","智慧治理","智慧社区","智能公共数据平台","智能政府"]# ================= 初始化设置 =================# 【核心步骤】将环境词汇加入jieba自定义词典,防止英文、数字和符号被错误切分for word in ENV_KEYWORDS: jieba.add_word(word, freq=99999, tag="n")# 加载停用词表def load_stopwords(path): stopwords = set()if os.path.exists(path): with open(path, "r", encoding="utf-8") as f:for line in f: stopwords.add(line.strip())print(f"[INFO] 成功加载停用词表,共 {len(stopwords)} 个词。")else:print(f"[WARN] 未找到停用词表 {path},将不进行停用词过滤。")return stopwordsstopwords_set = load_stopwords(STOPWORDS_PATH)# ================= 核心处理函数 =================def process_report(file_path, province, city, year):"""读取文件、分词、去停用词并统计词频""" try: with open(file_path, "r", encoding="utf-8") as f: text = f.read() except UnicodeDecodeError:# 尝试使用 GBK 编码读取(部分旧版政府报告可能是GBK格式) try: with open(file_path, "r", encoding="gbk") as f: text = f.read() except Exception as e:print(f"[ERROR] 无法读取文件 {file_path}: {e}")return None# jieba 精确模式分词 words = jieba.cut(text, cut_all=False)# 去除停用词、空白字符 filtered_words = [w for w in words if w.strip() and w not in stopwords_set]# 计算txt文件总词频(去除停用词后的有效词汇总数) total_freq = len(filtered_words)# 统计每个环境词汇的词频 word_freq_dict = {kw: 0 for kw in ENV_KEYWORDS}for w in filtered_words:if w in word_freq_dict: word_freq_dict[w] += 1# 计算环境词汇词频数加总 env_keywords_sum = sum(word_freq_dict.values())# 构建单条结果记录,严格按照要求的列顺序排列 record = {"省份": province, "城市": city, "年份": year} record.update(word_freq_dict) # 展开53个环境词汇及其词频 record["数字化政府词频数加总"] = env_keywords_sum # 放在各词汇词频之后 record["txt文件总词频数(去除停用词)"] = total_freq # 放在加总列之后return record# ================= 遍历文件夹并执行 =================def main(): results = []if not os.path.exists(REPORT_ROOT):print(f"[ERROR] 根目录 {REPORT_ROOT} 不存在,请检查路径!")return# 第一层:遍历省份文件夹 provinces = os.listdir(REPORT_ROOT)for province in provinces: province_path = os.path.join(REPORT_ROOT, province)if not os.path.isdir(province_path):continue# 第二层:遍历城市文件夹 cities = os.listdir(province_path)for city in cities: city_path = os.path.join(province_path, city)if not os.path.isdir(city_path):continue# 第三层:遍历年份txt文件 files = os.listdir(city_path)for file_name in files:if file_name.endswith(".txt"): year = file_name.replace(".txt", "") file_path = os.path.join(city_path, file_name)print(f"[PROCESSING] 正在处理: {province} - {city} - {year}") record = process_report(file_path, province, city, year)if record: results.append(record)# 导出为Excelif results: df = pd.DataFrame(results)# 按照省份、城市、年份排序 df = df.sort_values(by=["省份", "城市", "年份"]).reset_index(drop=True) df.to_excel(OUTPUT_EXCEL, index=False, engine="openpyxl")print(f"\n[DONE] 统计完成!共处理 {len(results)} 份报告,结果已保存至: {OUTPUT_EXCEL}")else:print("[WARN] 未找到任何可处理的txt文件。")if __name__ == "__main__": main()如是,就处理好了一份各城市政府工作报告中数字化政府词汇出现频数统计结果,包含城市、年份、各个词汇出现频数、数字化政府词汇词频数加总以及报告全文总词频数等信息。
数据获取
地级市政府工作报告文本、数字化政府词频统计结果为知识星球内部共享数据,可通过扫码或点击阅读原文加入星球获取。
参考文献
刘文革,耿景珠,杜明威.数“政”强贸:数字化政府建设与中国出口产品质量升级[J].数量经济技术经济研究,2024,41(06):67-87.
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:wyl860211@qq.com 。

